Evropské iniciativy AI-BOOST a EUCAIM hledají způsoby, jak pomocí generativní umělé inteligence zkvalitnit syntetická data pro vývoj zdravotnických algoritmů. Syntetické snímky mohou doplnit data o vzácných diagnózách a nedostatečně zastoupených skupinách pacientů. Věrohodný obraz ale nemusí být medicínsky správný a syntetická data nejsou automaticky anonymní.
Kapitoly článku:
Pět týmů dostane podporu na vývoj a validaci
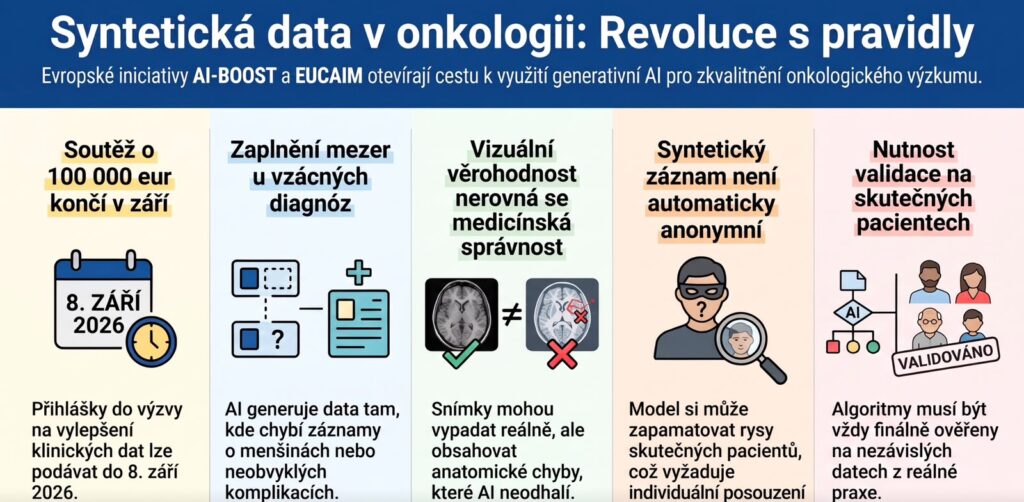
Evropské iniciativy AI-BOOST a EUCAIM otevřely soutěž Generative AI for Enhancement of Clinical Datasets. Přihlášky přijímají do 8. září 2026.
Generativní AI má zkvalitnit data pro výzkum nádorových onemocnění a analýzu medicínských snímků. Může doplňovat chybějící údaje a zobrazovací modality nebo vyrovnávat zastoupení pacientů podle věku, pohlaví, přidružených onemocnění či lokalizace nádoru.
Pět vybraných týmů získá po 28 500 eurech a postoupí do pětiměsíční fáze vývoje a validace. Vítěz obdrží dalších 100 tisíc eur.
Soutěž současně otevírá otázku, zda uměle vytvořené snímky rozšiřují klinické poznání, nebo pouze reprodukují nedostatky původních dat.
Pacient, který nikdy neexistoval
Algoritmus vytváří syntetická zdravotní data podle vztahů nalezených ve skutečných datech. Může jít o laboratorní výsledky, zdravotní záznamy, údaje z monitorovacích zařízení nebo snímky z CT, magnetické rezonance či mamografie. Nemají představovat záznam konkrétního pacienta, ale zachovávat medicínsky významné vlastnosti původní populace.
Podle FDA mohou syntetická data doplnit záznamy o vzácných onemocněních, neobvyklých komplikacích nebo méně zastoupených skupinách, zejména pokud potřebné množství skutečných dat nelze získat bezpečně nebo dostatečně rychle.
Více záznamů však automaticky neznamená větší rozmanitost. Tisíce snímků odvozených z několika podobných případů zvětší soubor, nikoli jeho výpovědní hodnotu. Přínos syntetických dat proto závisí na kvalitě zdrojových dat a způsobu validace. Na tento problém upozorňuje také studie zaměřená na vzácná onemocnění.
Věrohodný snímek nemusí být správný
Generativní model se zpravidla neučí pravidla lidské fyziologie, ale statistické vztahy v trénovacích datech. Přesvědčivě vyhlížející snímek proto může obsahovat anatomické či patologické chyby, které běžné metriky obrazové podobnosti neodhalí.
Model může zároveň převzít a znásobit chybné diagnózy, zkreslení spojená s konkrétními pracovišti nebo nedostatečné zastoupení některých skupin. Bez klinické kontroly tak syntetická data mohou pouze vytvářet zdání kvalitního a vyváženého souboru. Systematický přehled upozorňuje na chybějící jednotné hodnocení a potřebu rozsáhlejší validace klinické užitečnosti i ochrany soukromí.
Syntetická data nejsou automaticky anonymní
Syntetický záznam nepatří konkrétnímu člověku, přesto nemusí být anonymní. Generativní model si může zapamatovat části trénovacích dat a vytvořit výstup podobný skutečnému pacientovi, zejména u malých souborů, vzácných diagnóz a neobvyklých kombinací údajů.
Podle Evropského sboru pro ochranu osobních údajů (EDPB) je nutné anonymitu modelu posuzovat případ od případu. Za anonymní jej lze považovat pouze tehdy, pokud je identifikace osob nebo získání jejich údajů z trénovacího souboru velmi nepravděpodobné. Odstranění jména či identifikátoru nestačí, lze-li data spojit s konkrétním člověkem pomocí dalších informací; tehdy jde pouze o pseudonymizaci.
Přehledová analýza publikovaná v časopise Journal of Medical Internet Research navíc zjistila, že většina studií ochranu soukromí syntetických zdravotních dat neposuzuje a používané testy mohou riziko podhodnocovat.
Věrnost, užitečnost a soukromí
Syntetická klinická data je nutné hodnotit nejméně ve třech oblastech:
- Věrnost: Odpovídají data statistickým a medicínským charakteristikám skutečné populace?
- Užitečnost: Zlepší výkon algoritmu při konkrétní klinické úloze?
- Soukromí: Neumožňují odvodit informace o skutečných pacientech?
Mezi těmito požadavky může vznikat konflikt. Vysoká věrnost může zvýšit riziko, že si model zapamatuje údaje nebo charakteristické rysy konkrétních pacientů. Silnější ochrana soukromí může naopak snížit klinickou využitelnost výstupů.
Srovnání několika generativních metod ukazuje, že žádný model automaticky nevyniká ve všech třech oblastech.
| Co by měl vědět poskytovatel péče? Před použitím syntetických dat nebo algoritmu, který na nich byl trénován, by měl poskytovatel zdravotní péče znát odpovědi na několik otázek: • Z jakých skutečných dat generativní model vycházel? • Byla původní data kvalitní a reprezentativní? • Kontrolovali syntetické záznamy kliničtí odborníci? • Jak byla ověřena ochrana údajů pacientů? • Zlepšila syntetická data výsledky na nezávislém reálném souboru? • Funguje algoritmus spolehlivě v různých zařízeních a skupinách pacientů? Bez těchto informací nelze odlišit užitečné rozšíření klinických dat od produkce velkého množství věrohodně vypadajících, ale medicínsky sporných záznamů a snímků. |
Rozhoduje test na skutečných pacientech
Syntetická data mohou rozšířit trénovací soubor a simulovat vzácné situace, neměla by však být jediným podkladem pro hodnocení klinické bezpečnosti. Algoritmus je nutné ověřit na nezávislých datech skutečných pacientů, ideálně v externí multicentrické validaci zahrnující různá zařízení, přístroje, postupy a skupiny pacientů. Výsledky je třeba hodnotit souhrnně i podle věku, pohlaví, diagnózy a dalších relevantních charakteristik.
Tento požadavek odpovídá FDA zásadám správné praxe strojového učení pro zdravotnické prostředky, které zdůrazňují reprezentativní soubory a oddělení trénovacích a testovacích dat.
U vysoce rizikových AI systémů trénovaných na datech požaduje AI Act relevantní a dostatečně reprezentativní datové soubory odpovídající zamýšlenému účelu. Požadavky upravuje zejména článek 10 AI Act.
Doplněk, nikoliv náhrada
Syntetická data mohou urychlit vývoj zdravotnické AI a doplnit data o vzácných nebo obtížně dostupných případech. Soutěž pořádaná iniciativami AI-BOOST a EUCAIM může ukázat, které metody jsou využitelné v onkologickém zobrazování.
Uměle vytvořený snímek však sám o sobě nepředstavuje nový klinický důkaz a může přenášet omezení, chyby i zkreslení zdrojových dat. O bezpečnosti algoritmu proto musí rozhodnout výsledky na nezávislých datech skutečných pacientů a v reálné klinické praxi.
Zdroj: Evropská komise
Petr Moláček, digitalhealth.cz